

Cet article fait partie de notre guide Agents IA en entreprise.
En bref. Un agent IA est un programme où un modèle de langage décide lui-même des étapes et des outils à utiliser pour atteindre un objectif ; une automatisation classique suit un chemin écrit d’avance. Pour créer un agent IA en entreprise, nous appliquons 7 étapes : un cas d’usage borné, des données accessibles, des outils exposés par MCP, des règles écrites, une validation humaine, un journal et une mesure. Notre propre agent de prise de rendez-vous tourne ainsi depuis le 7 septembre 2026, avec 10 outils et des garde-fous codés. À l’inverse, nous avons gardé des règles déterministes pour le rapprochement de devis, les relances de facturation et le tri de factures : quand la règle est exacte, un modèle n’apporte que de l’incertitude. Côté coût, les tarifs publiés par Anthropic vont de 0,10 $ à 2 $ par million de jetons en entrée selon le modèle (relevé du 14 novembre 2026).
« Créer un agent IA » est devenu la demande numéro un dans nos rendez-vous découverte. Derrière, il y a souvent trois besoins différents : un chatbot, une automatisation fiable, ou un vrai agent qui raisonne et agit. Cet article explique comment nous distinguons les trois, notre méthode pour construire un agent, et les cas où nous avons refusé d’en mettre un. Pour la vue d’ensemble de ce que nous proposons, notre page agents IA donne le cadre ; ici, on entre dans la cuisine.
Agent IA, automatisation déterministe ou chatbot : trois objets différents
Anthropic, qui édite Claude, pose la distinction la plus claire que nous connaissions : « Workflows are systems where LLMs and tools are orchestrated through predefined code paths. Agents, on the other hand, are systems where LLMs dynamically direct their own processes and tool usage, maintaining control over how they accomplish tasks » (Building effective agents, Anthropic). Autrement dit : dans une automatisation, le chemin est écrit par un humain et le modèle n’intervient, au mieux, qu’à une étape ; dans un agent, le modèle choisit lui-même la suite des étapes. Le chatbot est un troisième objet : il converse, mais n’agit pas sur vos systèmes, ou très peu.
| Critère | Automatisation déterministe (n8n, scripts) | Chatbot IA | Agent IA |
|---|---|---|---|
| Qui décide des étapes | Un humain, à l’avance | Personne : il répond, il n’agit pas | Le modèle, à chaque exécution |
| Résultat pour une même entrée | Toujours le même | Variable | Variable |
| Accès à vos outils | Oui, par connecteurs fixes | Rarement, ou en lecture | Oui, par des outils exposés (MCP, API) |
| Quand ça casse | Erreur visible, reproductible | Réponse à côté | Action inattendue, parfois silencieuse |
| Bon usage | Règles exactes, volumes, facturation | Questions fréquentes, premier niveau de support | Demandes variées, en langage naturel, qui exigent plusieurs actions |
| Coût de fonctionnement | Hébergement seul | Jetons par conversation | Jetons par tâche, souvent plusieurs appels |
Notre lecture : si vous pouvez écrire la règle sur une feuille, c’est une automatisation. Si la demande arrive en langage libre et exige d’enchaîner plusieurs actions dans vos outils, c’est un agent. Si l’on veut seulement répondre à des questions, c’est un chatbot, et notre guide du chatbot IA en entreprise traite ce cas à part.
Créer un agent IA pour son entreprise : la méthode en 7 étapes
Voici la procédure que nous suivons chez nos clients et pour nos propres outils. Elle tient en sept étapes, dans cet ordre. Sauter l’une d’elles se paie au moment où l’agent fait une chose qu’on ne lui avait pas interdite.
- Borner le cas d’usage. Une tâche, un périmètre, une liste de ce que l’agent ne fait pas. « Gérer mon agenda » est trop large ; « poser mes congés, bloquer un créneau, planifier un rendez-vous déjà convenu » est un périmètre.
- Rendre les données accessibles. L’agent ne lit que ce dont il a besoin, par une interface, jamais par un accès direct à la base. On décide ici ce qui n’entre jamais dans son contexte (voir plus bas).
- Exposer des outils via MCP. Chaque action possible est un outil nommé, avec ses paramètres et sa description. Le modèle n’a pas de clé d’API : il a des outils.
- Écrire les règles. Les garde-fous vont dans le code des outils (une heure passée est refusée par le serveur, pas par la bonne volonté du modèle) et dans les descriptions que le modèle lit.
- Placer la validation humaine avant toute action irréversible ou visible de l’extérieur : envoi, suppression, paiement.
- Tenir un journal. Chaque appel d’outil est enregistré avec qui, quand, quoi. Sans journal, un agent qui dérape est invisible.
- Mesurer. Taux de tâches finies sans intervention, erreurs, jetons consommés. Puis élargir le périmètre, pas avant.
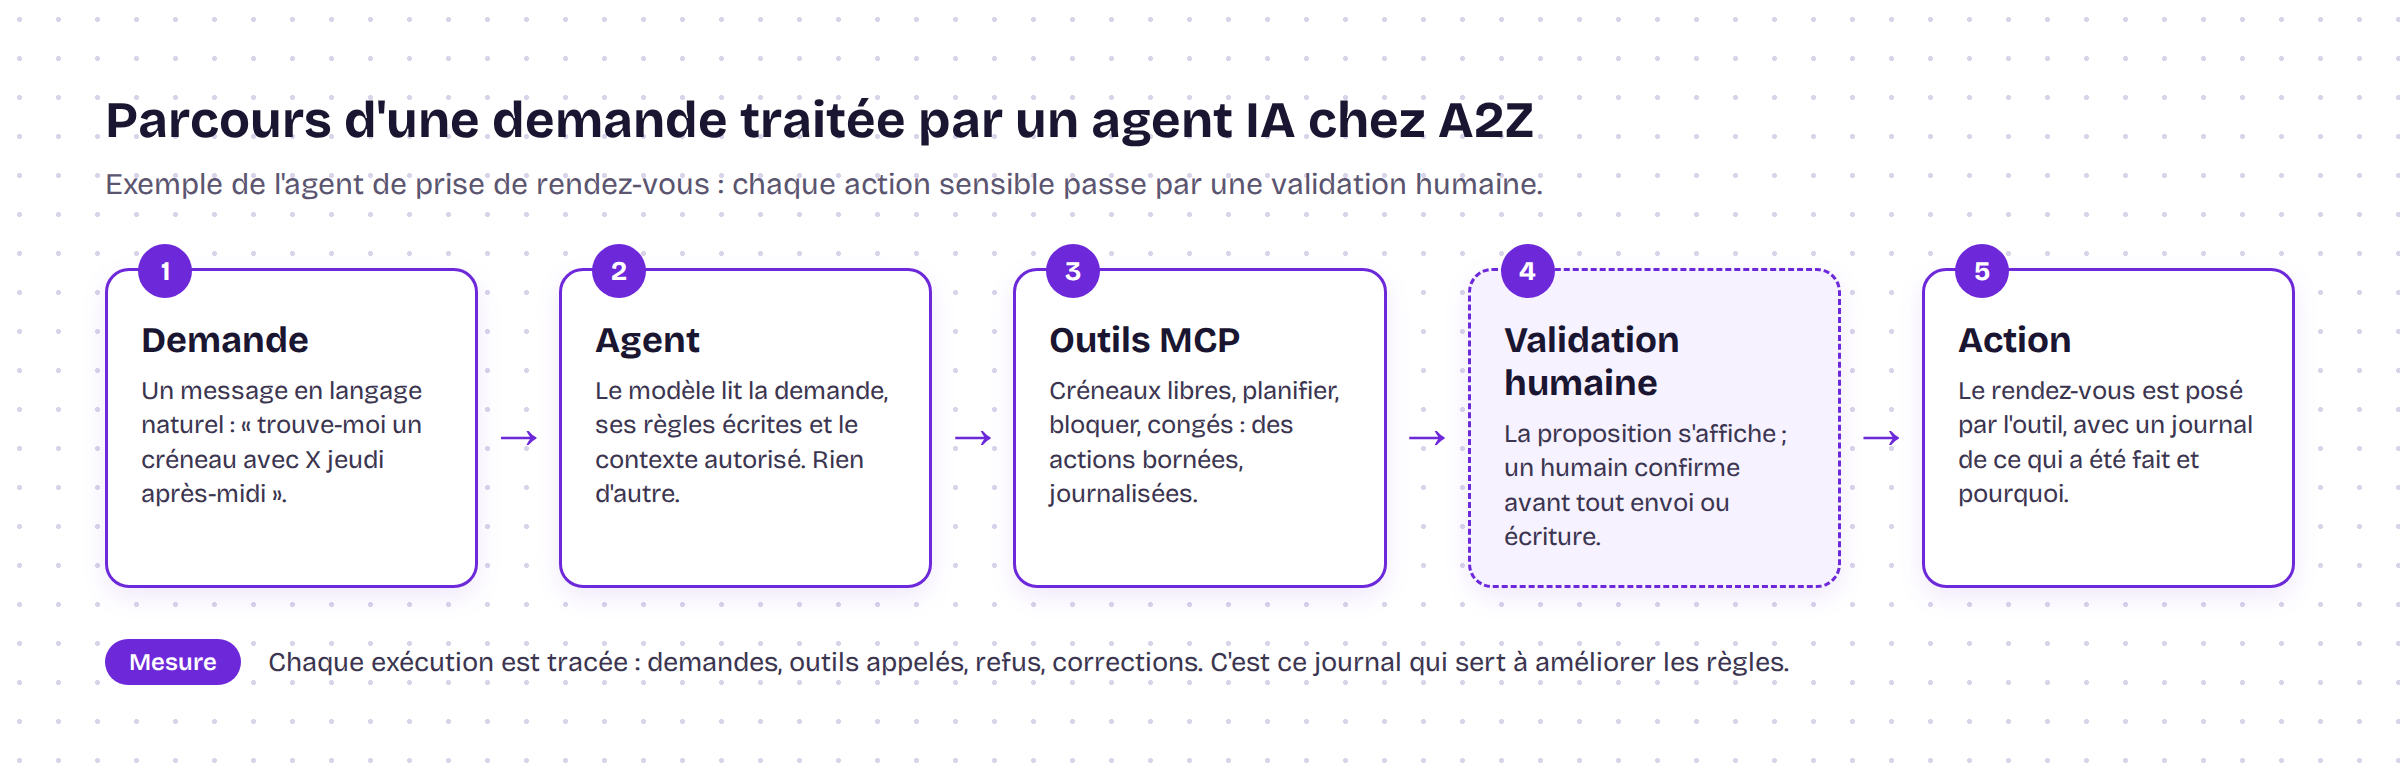
- La demande arrive en langage naturel (« je suis en vacances la semaine prochaine »).
- L’agent l’interprète et choisit les outils à appeler.
- Les outils MCP exécutent chaque action dans les limites codées (dates, droits, périmètre).
- Un humain valide quand l’action est irréversible ou visible de l’extérieur.
- L’action est faite, puis écrite dans le journal.
Pourquoi MCP plutôt qu’un accès direct aux API
MCP, pour Model Context Protocol, est défini par ses auteurs comme « an open-source standard for connecting AI applications to external systems » (modelcontextprotocol.io). Concrètement, un serveur MCP publie une liste d’outils avec un nom, une description et un schéma de paramètres ; le client (Claude, par exemple) les découvre et les appelle. L’intérêt pour un agent d’entreprise est double. D’abord, le modèle ne voit que les outils qu’on lui donne : pas de clé d’API en clair, pas de requête libre sur la base. Ensuite, chaque outil est un endroit où coder une règle métier que le modèle ne peut pas contourner. Nous détaillons le protocole dans notre guide complet de MCP. La description de l’outil est la première règle que le modèle lit : nous les écrivons en français, avec des réponses lisibles.
Notre cas réel : l’agent de prise de rendez-vous
Depuis le 7 septembre 2026, notre prise de rendez-vous ne passe plus par Calendly mais par un service maison, hébergé sur notre serveur (voir ce qu’est un VPS). Il sert la page de rendez-vous d’A2Z et celle de GMB Club, envoie les confirmations et les rappels, et crée la fiche dans notre CRM. Par-dessus, un connecteur MCP permet à chacun de nous de piloter son agenda depuis Claude, en français. Le cas d’usage qui a tout déclenché tient en une phrase : « pendant une semaine je suis en vacances, je ne veux pas prendre de rendez-vous ».
Les outils exposés à l’agent
Le connecteur expose 10 outils, chacun borné à une action : creneaux_libres (les créneaux disponibles sur une période), planifier_rendez_vous (poser un rendez-vous déjà convenu avec quelqu’un et lui envoyer l’invitation avec le lien de visioconférence), bloquer_creneau, poser_conges, liberer_journee, mes_disponibilites, prochains_rendez_vous, annuler_rendez_vous, regles_de_confort et liens_de_reservation. L’identité vient du jeton de connexion : chaque personne agit sur son propre agenda, et un outil qui touche à l’agenda d’un collègue doit le nommer explicitement. Aucun outil ne donne accès à la base de données, ni à la messagerie, ni au CRM en écriture libre.
Les garde-fous, dans le code et dans les consignes
- Un rendez-vous convenu passe par l’outil, jamais par une invitation d’agenda envoyée au nom d’une autre adresse. Une invitation Google Agenda partie au nom de notre adresse de marque est refusée par les messageries qui appliquent la politique DMARC du domaine. La règle est écrite dans la description de l’outil, que le modèle lit avant d’agir.
- Aucune invitation sans accord. L’agent ne planifie qu’un rendez-vous « déjà convenu avec la personne » : c’est le texte même de l’outil. Il ne prospecte pas, il n’envoie pas de proposition à une adresse inconnue.
- Des règles de confort codées côté serveur : nombre maximum de rendez-vous par jour, heure limite certains jours (« pas de vendredi après 16 h »), écart minimum entre deux rendez-vous. Elles s’appliquent au calcul des créneaux, que la demande vienne du site ou de l’agent.
- Le serveur refuse ce que le modèle pourrait se tromper à demander : une heure passée ou déjà prise est rejetée par le code, pas par la consigne.
- Les suppressions définitives exigent un accord explicite de la personne connectée, demandé par l’agent avant l’appel.
Le connecteur a été vérifié de bout en bout avant la mise en service : inscription du client, autorisation, appel des outils, puis le cas « vacances » en conditions réelles, les créneaux disparaissant aussitôt des deux sites. Le passage du prototype à la production est un sujet en soi, que nous traitons dans déployer un agent IA du POC à la production.
Trois cas où nous avons gardé des règles déterministes
Un agent n’est pas la réponse par défaut. Quand la règle métier est exacte et connue, un modèle de langage ajoute de l’incertitude là où il n’y en avait pas, et un coût en jetons à chaque exécution. Voici trois cas réels, anonymisés, où nous avons choisi, ou conservé, de l’automatisation classique.
Le rapprochement de devis d’un grossiste
Un grossiste nous a confié une plateforme de devis qui rapproche les demandes de ses clients avec son catalogue. Deux raisons ont écarté l’agent. D’abord, les règles de correspondance sont exactes : nom latin, nom commun, conditionnement, disponibilité. Elles se codent et se testent, et un résultat différent d’une exécution à l’autre serait un défaut, pas une qualité. Ensuite, l’accord de traitement signé avec ce client interdit que ses données (prix d’achat, prix de vente, fournisseurs, contacts) partent vers un service d’IA tiers. Le moteur de rapprochement est donc déterministe, et le modèle n’intervient nulle part dans le flux de production. Même le développement s’est fait sur un jeu de données synthétique, de même structure et de même volume, contenu inventé.
Les relances de facturation
Une relance de facture obéit à un calendrier : échéance, J+7, J+15, J+30, avec un texte différent à chaque palier et un arrêt dès que le paiement est enregistré. C’est une automatisation déterministe dans notre outil de gestion. Aucun agent n’y touche, parce qu’un message de relance envoyé par erreur, ou avec un montant faux, coûte une relation client. La règle est écrite une fois, testée, et elle fait exactement la même chose chaque jour.
Le classement des factures reçues par mail
Pour une société de gestion, nous avons migré un scénario qui lit une boîte mail, extrait les factures PDF en pièce jointe et les dépose dans un espace de stockage partagé. Le flux est un workflow n8n, déclenché toutes les 15 minutes, au chemin fixe. Le modèle de langage n’y a qu’un rôle : lire le texte du PDF et proposer un nom de fichier normalisé, du type fournisseur, date, montant. S’il n’y parvient pas, le fichier est déposé quand même avec un préfixe « à renommer », et un humain finit le travail. Le modèle ne décide ni où va le fichier, ni s’il faut le déposer : il nomme, c’est tout. Une étape bornée, avec un repli qui ne casse rien.
Sécurité et données : ce qui n’entre jamais dans le contexte
Le contexte d’un modèle, c’est tout ce qu’on lui envoie : consignes, documents, résultats d’outils, messages d’erreur. Tout ce qui y entre peut en sortir, dans une réponse ou dans les journaux du fournisseur. Nos règles, appliquées chez nos clients comme chez nous :
- Les données personnelles et commerciales des clients restent hors du contexte : contacts, prix, fournisseurs, messages entrants. Ni directement, ni par la bande (résultat d’une requête, trace d’erreur contenant la ligne fautive, fichier d’exemple déposé dans le code).
- Le développement se fait sur des jeux de données synthétiques, même structure, contenu inventé. Quand un cas résiste, on remonte un échantillon anonymisé, jamais la donnée brute.
- L’accord de traitement est au contrat, pas dans une bonne intention : il dit ce qui peut partir vers un service d’IA tiers, et ce qui ne le peut pas. Quand il interdit toute sortie, l’agent n’est pas la bonne architecture, ou alors le modèle tourne chez le client.
- L’IA locale quand les données ne doivent pas sortir. Pour un organisme de formation qui gère plusieurs milliers d’apprenants, nous installons le modèle sur un serveur en Union européenne, souscrit au nom du client et dont il est propriétaire : les données ne quittent pas sa machine. Ce montage, instance applicative plus serveur GPU séparé sur un réseau privé, est aussi celui que nous avons retenu pour le grossiste.
- Les secrets ne passent jamais par le modèle : les clés d’API vivent dans la configuration du serveur MCP, lisible par le seul administrateur.
Combien coûte un agent IA en jetons
Honnêtement : nous n’avons pas de mesure publiée sur un mois pour notre agent de rendez-vous. Il sert deux personnes, quelques appels par jour, et nous n’avons pas isolé sa consommation de celle de nos autres usages. Nous ne donnerons donc pas de chiffre maison. Ce que nous pouvons donner, c’est l’ordre de grandeur des tarifs publics, qui permet de faire son propre calcul.
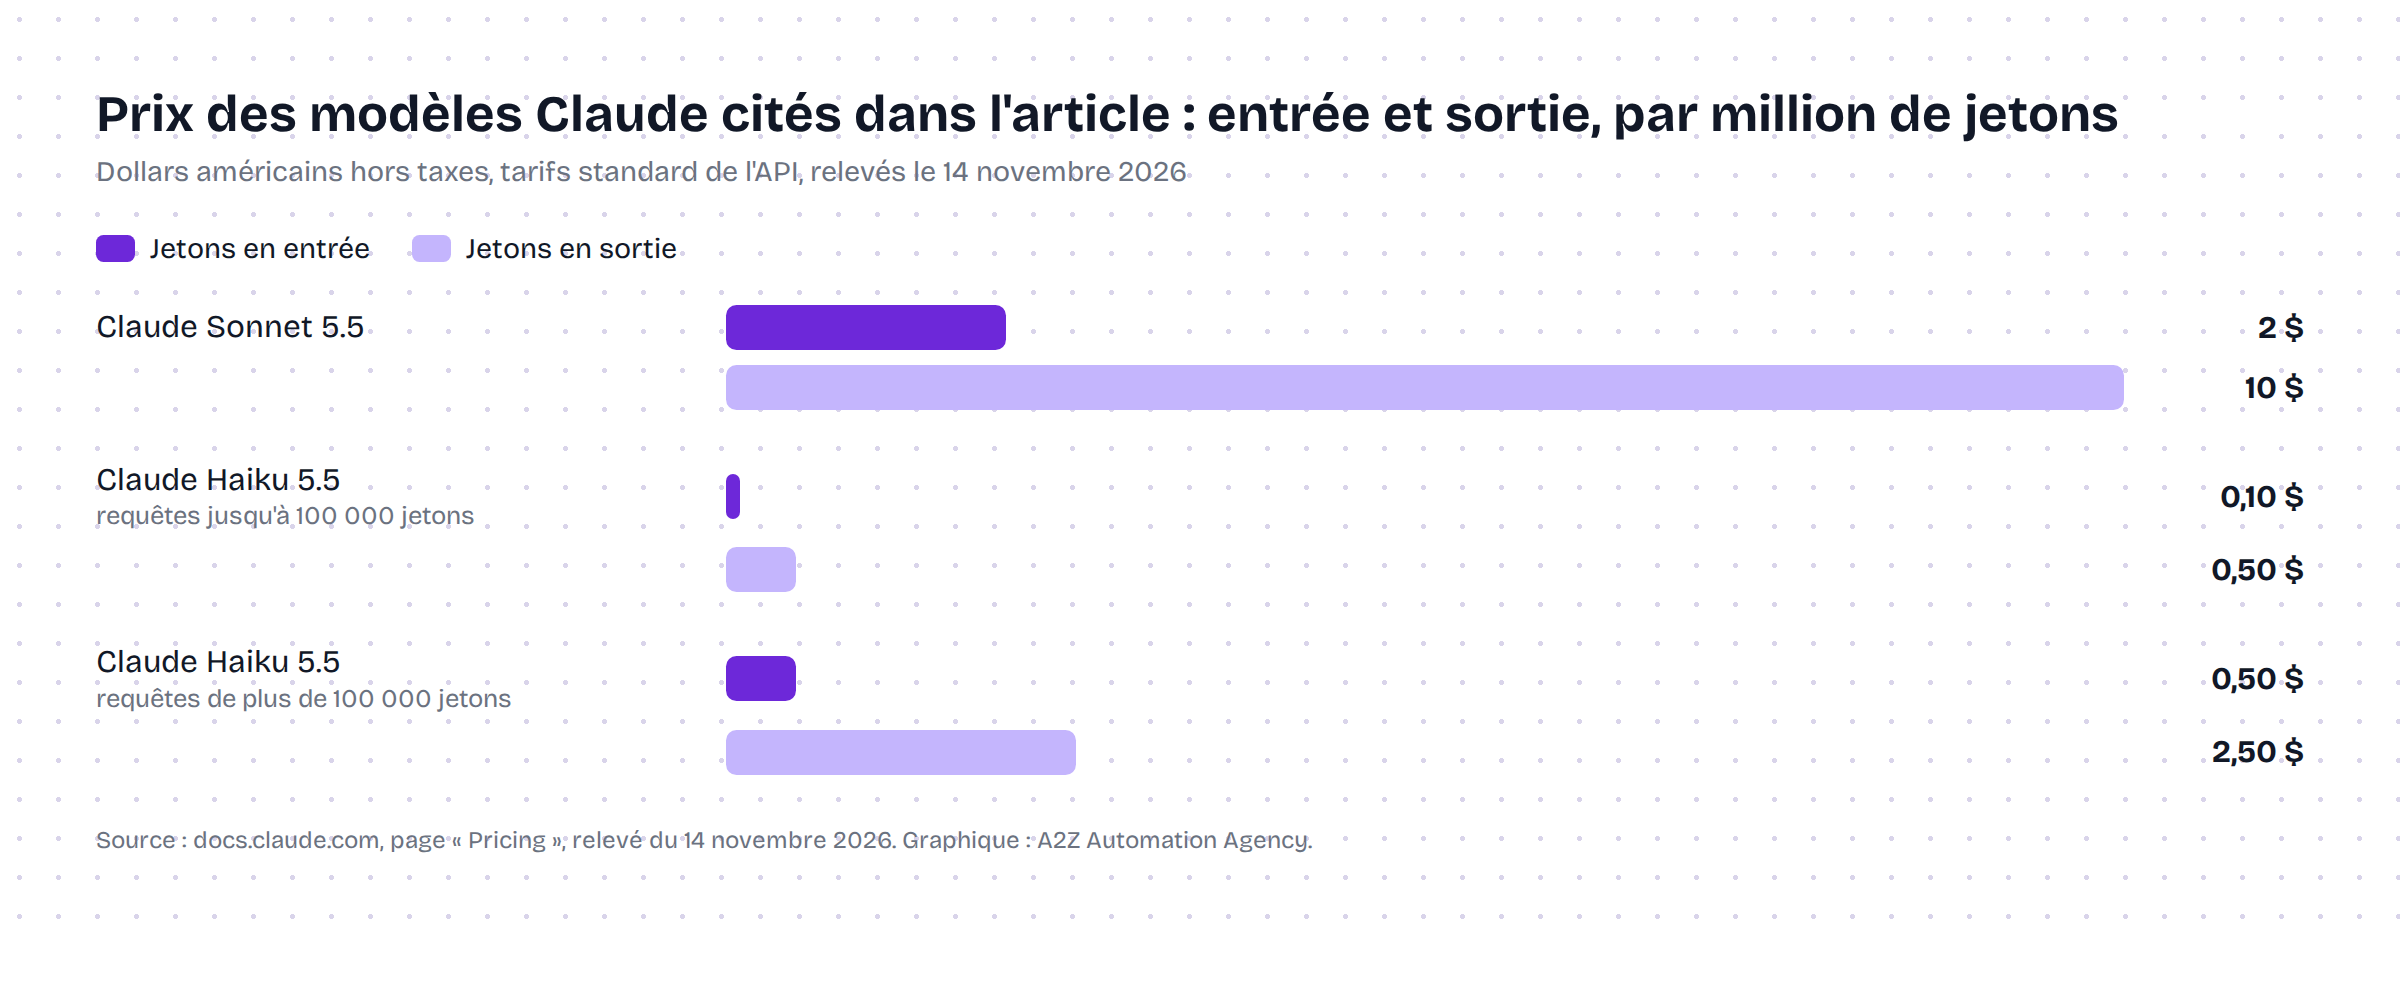
Tarifs relevés le 14 novembre 2026 sur la page de tarification de la documentation Claude (prix en dollars américains, par million de jetons, hors taxes) :
| Modèle | Entrée | Sortie | Usage indiqué par Anthropic |
|---|---|---|---|
| Claude Sonnet 5.5 | 2 $ | 10 $ | « The best combination of speed and intelligence » |
| Claude Haiku 5.5 (requêtes jusqu’à 100 000 jetons) | 0,10 $ | 0,50 $ | « For high-volume, latency-sensitive tasks such as classification, extraction, and routing » |
| Claude Haiku 5.5 (requêtes de plus de 100 000 jetons) | 0,50 $ | 2,50 $ | idem |
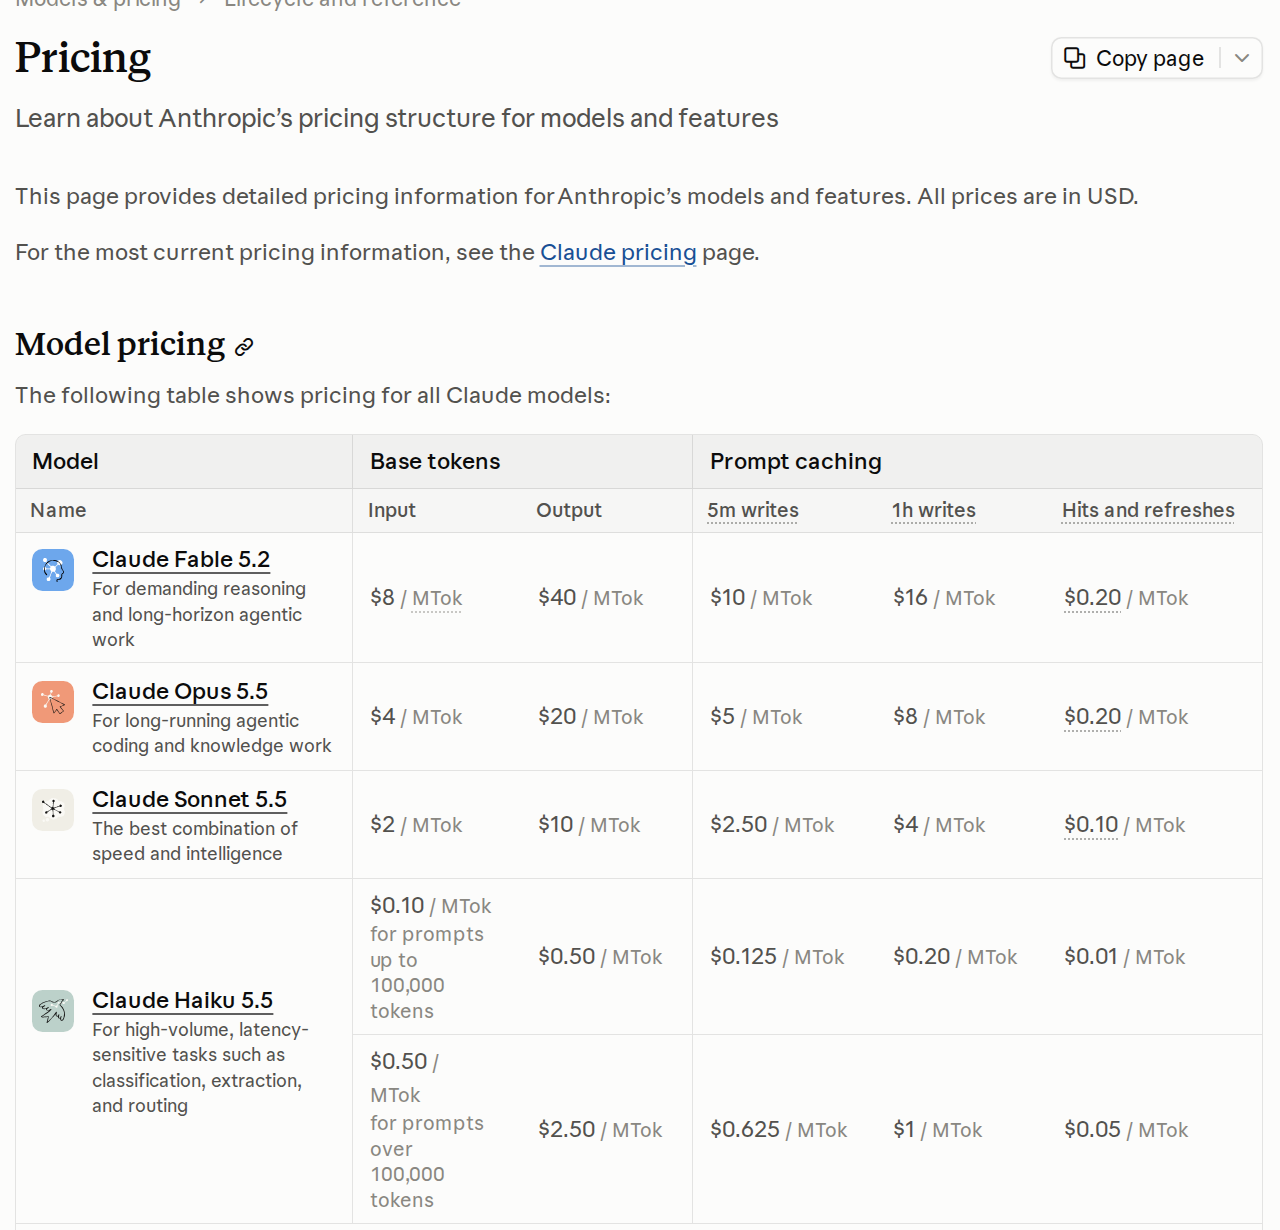
Un appel d’agent typique embarque les descriptions des outils, la demande et les résultats des outils : quelques milliers de jetons en entrée, quelques centaines en sortie, répétés à chaque tour. Le vrai poste de coût n’est pas le prix unitaire mais le nombre d’appels : un agent qui boucle dix fois coûte dix fois plus. D’où l’étape 7 de la méthode : mesurer. Notre article sur l’agent IA et la productivité en entreprise replace ces coûts face au temps humain qu’ils remplacent.
Ce que nous refusons d’automatiser
Un agent capable d’agir pose la question de ce qu’on le laisse faire. Trois refus fermes, que nous écrivons au cadrage :
- Les envois en masse non consentis. Un agent qui écrit et envoie des messages à des personnes qui n’ont rien demandé, c’est du spam avec un meilleur style. Les envois sortants passent par des listes consenties, des volumes plafonnés et une désinscription réelle ; un agent peut préparer, un humain valide, un outil déterministe envoie.
- Les décisions juridiques ou médicales sans humain. Un agent peut préparer un dossier, résumer, proposer. La décision qui engage une personne (un refus, un diagnostic, un avis juridique) est prise et signée par un professionnel. Nous ne construisons pas d’agent qui tranche à sa place.
- L’accès aux données bancaires sans séparation. Un agent n’a jamais, dans le même contexte, la lecture des comptes et le pouvoir de payer. Les flux financiers sont déterministes, journalisés et validés par une personne ; au mieux, l’agent lit un état et prépare une écriture qu’un humain confirme.
À cela s’ajoute une règle de bon sens : tout ce qui est irréversible ou visible de l’extérieur (suppression, envoi, publication, paiement) passe par une confirmation humaine, même quand l’agent est sûr de lui. Surtout quand il est sûr de lui.
Les limites
Ce que cet article ne prouve pas : qu’un agent soit plus rentable qu’une automatisation classique dans votre cas. Nous n’avons pas de mesure de coût publiée pour notre agent de rendez-vous, et les tarifs cités sont ceux d’un fournisseur, un jour donné, en dollars. Un agent reste non déterministe : avec les mêmes garde-fous, il peut interpréter une demande ambiguë de travers, et seuls le journal et la validation humaine le rattrapent. Les modèles, les prix et le protocole MCP évoluent vite ; ce qui est écrit ici date du 14 novembre 2026. Enfin, notre expérience porte sur des PME et des outils internes, pas sur des systèmes à très fort volume ni sur des secteurs réglementés au-delà de ce que nous refusons d’automatiser.
Comment nous pouvons vous aider
Nous cadrons le cas d’usage, nous tranchons entre agent et automatisation classique, puis nous construisons le serveur MCP, les garde-fous et le journal, sur votre serveur ou le nôtre. Tout dépend du périmètre et du niveau de suivi : on en parle sur notre page de rendez-vous, qui tourne elle-même sur l’agent décrit plus haut.
Questions fréquentes
Comment créer un agent IA sans savoir programmer ?
Des outils comme n8n ou les connecteurs de Claude permettent d’assembler un agent sans écrire tout le code. En revanche, les garde-fous sérieux (règles côté serveur, validation humaine, journal) demandent un développement. Pour un premier agent, commencez par un cas borné, en lecture seule, avant de lui donner le droit d’agir.
Quelle différence entre un agent IA et un chatbot ?
Un chatbot répond ; un agent agit. Le chatbot converse à partir de ce qu’il sait, l’agent appelle des outils (agenda, CRM, fichiers) pour accomplir une tâche. Un chatbot peut devenir un agent le jour où on lui donne des outils, et c’est à ce moment-là que les règles deviennent indispensables.
Agent IA ou automatisation classique : comment choisir ?
Si la règle s’écrit sur une feuille et que le même cas doit toujours donner le même résultat, choisissez l’automatisation classique. Si les demandes arrivent en langage libre et exigent d’enchaîner plusieurs actions, un agent se justifie. Beaucoup de bons systèmes mélangent les deux : un flux fixe avec une seule étape confiée au modèle.
Qu’est-ce que MCP et faut-il l’utiliser ?
MCP est un standard ouvert qui décrit comment une application d’IA découvre et appelle des outils externes. Nous l’utilisons pour tous nos agents, parce qu’il impose de nommer chaque action et permet d’y coder des règles que le modèle ne peut pas contourner.
Combien coûte un agent IA par mois ?
Cela dépend du nombre d’appels et du modèle. Les tarifs publics d’Anthropic relevés le 14 novembre 2026 vont de 0,10 $ à 2 $ par million de jetons en entrée et de 0,50 $ à 10 $ en sortie selon le modèle. Nous n’avons pas de mesure publiée pour notre propre agent, et nous recommandons de mesurer dès le premier mois.
Peut-on faire tourner un agent IA sans envoyer de données à un fournisseur ?
Oui, avec un modèle installé sur un serveur que vous possédez, en général avec une carte graphique dédiée. C’est ce que nous mettons en place quand un contrat interdit toute sortie de données. Les modèles locaux sont moins puissants que les meilleurs modèles en ligne, mais suffisants pour beaucoup de tâches bornées.
Vous voulez mettre ça en place chez vous ?
Adam, qui conçoit nos workflows n8n et nos agents IA, regarde votre cas avec vous : 30 minutes en visio pour comprendre vos processus, repérer ce qui vaut la peine d'être automatisé et vous dire comment nous le ferions.
Choisir un créneau


