

En bref. Anthropic a sorti Claude Fable 5.2 le 9 novembre 2026, avec son jumeau Claude Mythos 5.2 réservé aux organisations vérifiées. Contexte de 1 million de jetons, 128 000 jetons de sortie, réflexion adaptative toujours active, et un prix en baisse : 8 $ le million de jetons en entrée et 40 $ en sortie, contre 10 $ et 50 $ pour Fable 5.1 (relevé du 14 novembre 2026). Sur AutomationBench, le test des tâches professionnelles automatisées, Anthropic annonce 51,4 % contre 31,4 % pour Fable 5.1 et 42,5 % pour Opus 5.5. Chez nous, le modèle qui écrit les plans de notre chaîne de montage vidéo est Opus 5.5 : 93 plans, 62 % acceptés par le moteur au premier essai, environ 0,08 $ le plan. Nous expliquons ce qu’un passage à Fable 5.2 changerait, et pourquoi nous ne l’avons pas encore mesuré.
Dix semaines après Claude Fable 5.1, Anthropic remet le couvert. Nous avons lu l’annonce, relevé les prix sur les pages officielles le 14 novembre 2026, et regardé ce que ce modèle changerait concrètement dans un agent IA en production, en prenant l’exemple que nous connaissons le mieux : notre chaîne de montage vidéo automatique, où Claude écrit un plan de montage à partir d’un mémo vocal. Pas de benchmark maison inventé : les chiffres de cet article sont ceux d’Anthropic, ceux des pages tarifs, et ceux que nous avons réellement comptés dans notre service.
Ce qu’Anthropic a annoncé le 9 novembre 2026
Les notes de version de la plateforme Claude le disent en une phrase : « We’ve launched Claude Fable 5.2 (claude-fable-5-2), built for demanding reasoning and long-horizon agentic work. » Et plus loin : « Both models have a 1M token context window, 128k max output tokens, and always-on adaptive thinking. » (Claude Platform release notes, 9 novembre 2026). Les « deux modèles », ce sont Fable 5.2 et Mythos 5.2 : comme pour la génération précédente, Mythos est le même modèle avec des garde-fous allégés, réservé aux organisations passées par les programmes de vérification d’Anthropic (cybersécurité, sciences de la vie). Pour une entreprise française, la question ne se pose pas : c’est Fable 5.2.
La page produit précise la position du modèle : « Claude Fable 5.2 is our strongest lead agent. In our testing, we found it can run ambiguous engineering work for days, coordinate hundreds or even more than a thousand subagents, and use tools more efficiently along the way. » (anthropic.com, Claude Fable 5.2). Le mot important est « lead agent » : Anthropic ne vend plus Fable comme le modèle qu’on appelle pour chaque petite tâche, mais comme celui qui pilote les autres. Le modèle est disponible dans les offres Pro, Max, Ultra, Team et Enterprise de claude.ai, sur l’API, et chez AWS, Google Cloud et Microsoft Foundry.
Les prix publics, relevés le 14 novembre 2026
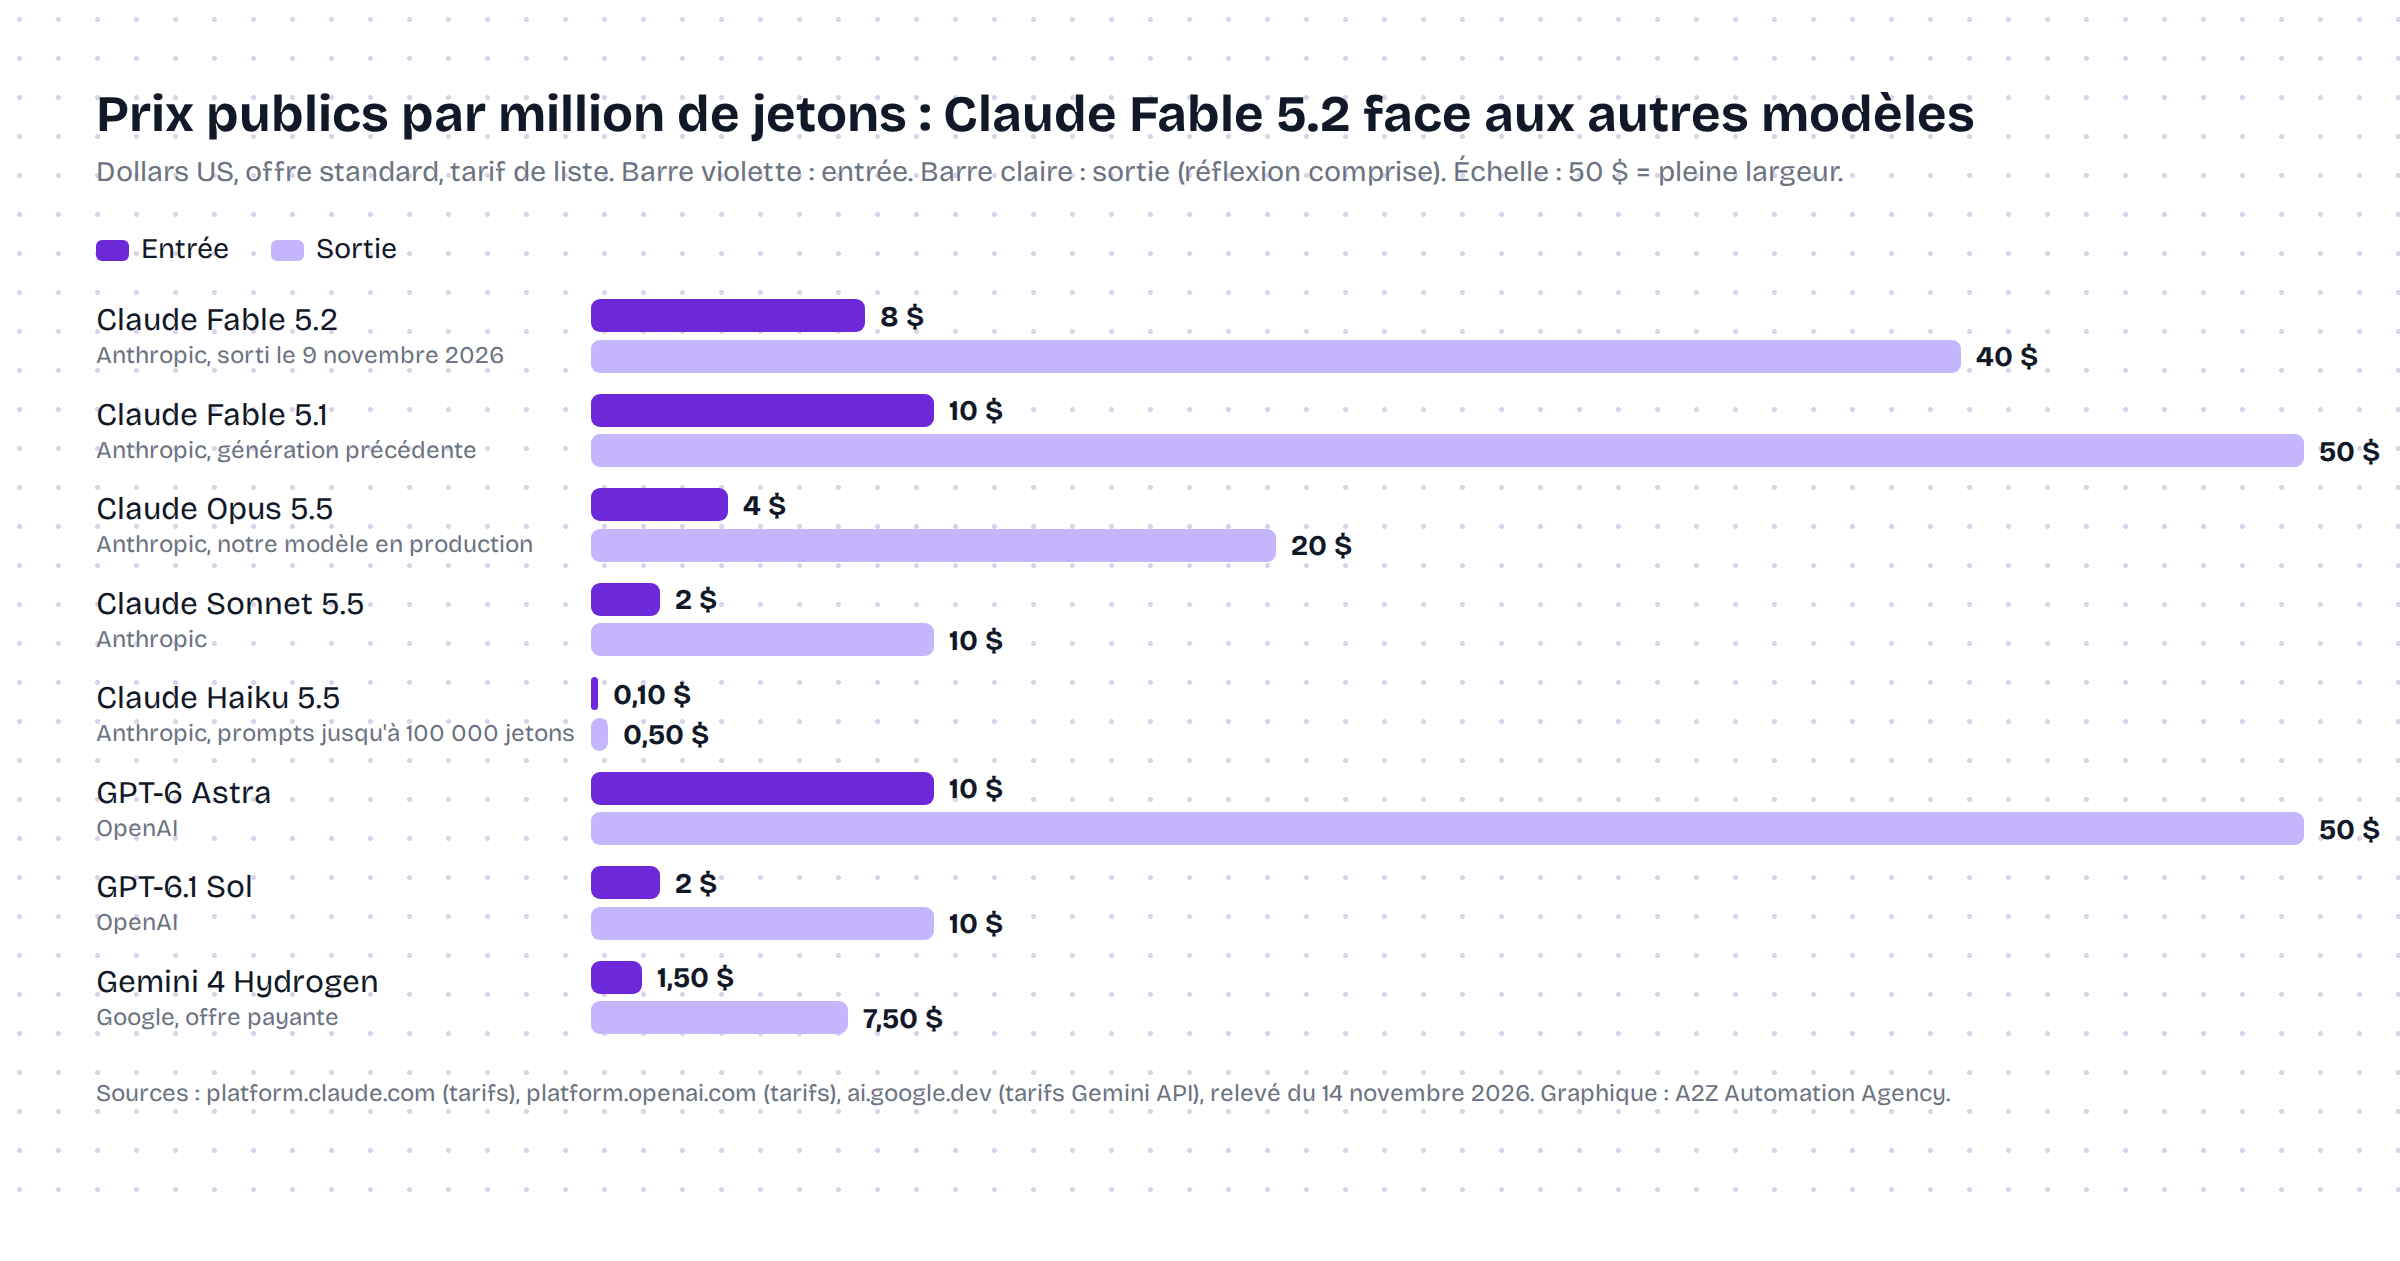
C’est la première fois qu’une version de Fable baisse de prix. La page produit l’écrit : « Claude Fable 5.2 is priced at $8 per million input tokens and $40 per million output tokens, down from $10 and $50 for Fable 5.1. Cache reads cost $0.20 per million tokens. » Nous avons recoupé avec la page tarifs de la plateforme Claude, et comparé aux concurrents sur les pages d’OpenAI et de Google, le même jour.
| Modèle | Entrée (par million de jetons) | Sortie | Lecture de cache | Source |
|---|---|---|---|---|
| Claude Fable 5.2 | 8 $ | 40 $ | 0,20 $ | platform.claude.com |
| Claude Fable 5.1 | 10 $ | 50 $ | 0,25 $ | platform.claude.com |
| Claude Opus 5.5 | 4 $ | 20 $ | 0,20 $ | platform.claude.com |
| Claude Sonnet 5.5 | 2 $ | 10 $ | 0,10 $ | platform.claude.com |
| Claude Haiku 5.5 (prompts jusqu’à 100 000 jetons) | 0,10 $ | 0,50 $ | 0,01 $ | platform.claude.com |
| GPT-6 Astra | 10 $ | 50 $ | 1 $ | platform.openai.com |
| GPT-6.1 Sol | 2 $ | 10 $ | 0,10 $ | platform.openai.com |
| Gemini 4 Hydrogen (offre payante) | 1,50 $ | 7,50 $ | 0,075 $ | ai.google.dev |
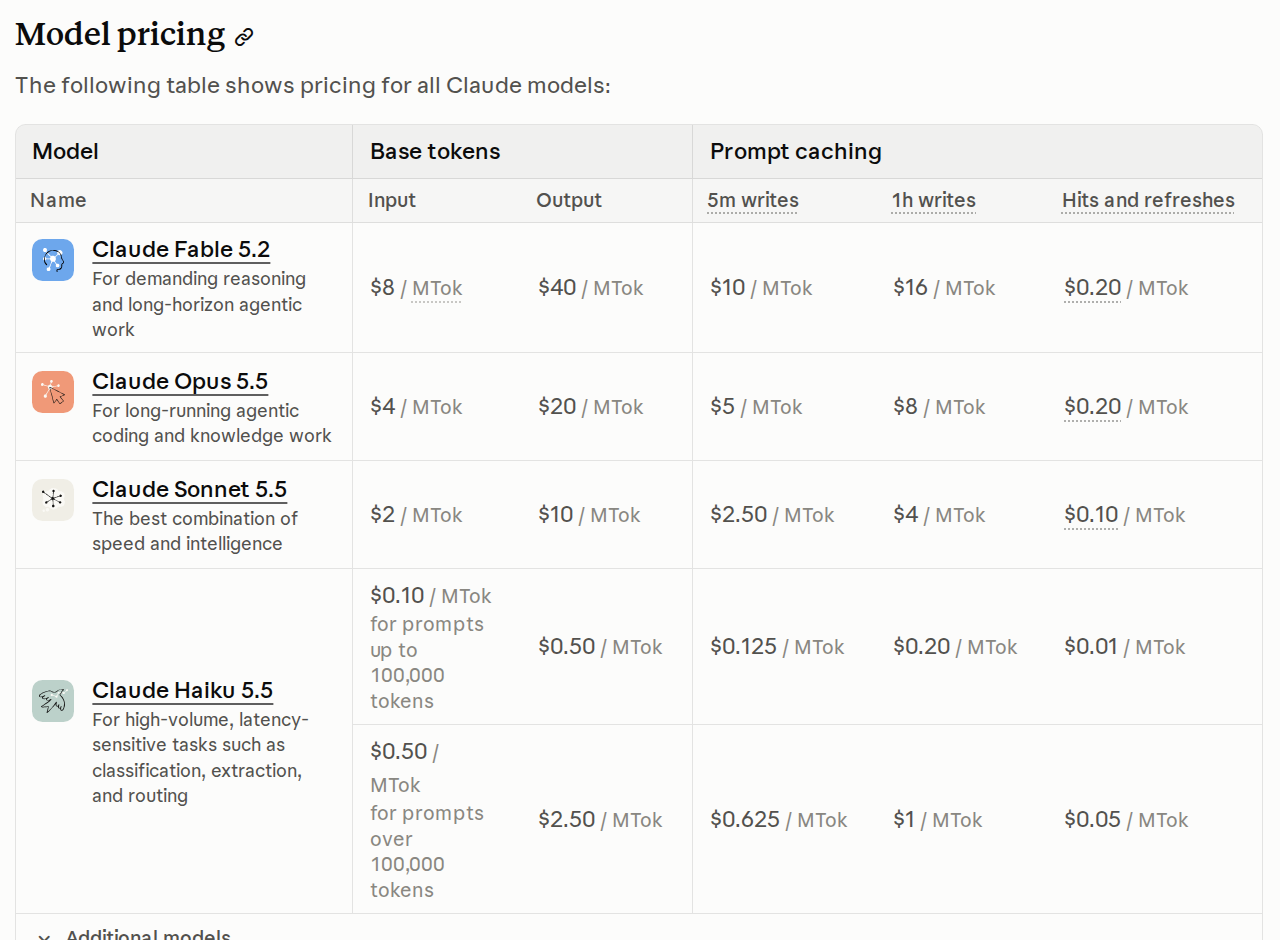
Deux lectures de ce tableau. D’abord, Fable 5.2 coûte toujours deux fois Opus 5.5, en entrée comme en sortie : la baisse ne change pas la hiérarchie. Ensuite, la lecture de cache est désormais au même prix sur les deux modèles, 0,20 $. Pour un agent qui relit à chaque appel le même gros prompt système, et c’est le cas de tous les nôtres, la différence de coût entre Fable 5.2 et Opus 5.5 se joue donc sur les jetons de sortie, pas sur le contexte. Le mode rapide (« fast mode ») de Fable 5.2 est facturé 16 $ et 80 $, le double.
Les résultats annoncés sur les tâches d’agent
Anthropic publie ses propres benchmarks sur la page produit. Nous en gardons quatre, ceux qui ressemblent au travail d’un agent en entreprise : exécuter des tâches métier automatisées, corriger du code, utiliser un ordinateur, chercher sur le web.
| Benchmark (source Anthropic) | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| AutomationBench (tâches professionnelles automatisées) | 51,4 % | 31,4 % | 42,5 % | 41,4 % | 53,9 % |
| FrontierSWE v2 (correction de code) | 69,9 % | 56,3 % | 62,3 % | 65,5 % | 61,2 % |
| OSWorld 2.1, jeu hors ligne, score partiel (utilisation d’un ordinateur) | 89,3 % | 83,5 % | 87,2 % | 79,5 % | 81,5 % |
| WANDR, score relâché (recherche agentique) | 82,1 % | 68,7 % | 72,3 % | non publié | non publié |
Ce que nous retenons, avec la prudence qui s’impose pour des chiffres publiés par l’éditeur lui-même : le saut le plus net est sur AutomationBench, 20 points de plus que Fable 5.1, et c’est le test le plus proche de ce que nous vendons. Sur ce même test, Gemini 4 Carbon reste devant. Sur l’utilisation d’un ordinateur, l’écart entre Fable 5.2 et Opus 5.5 n’est que de 2 points : si votre agent clique dans des interfaces, le modèle deux fois moins cher fait presque aussi bien, selon Anthropic.
Ce qui change pour qui développe un agent
Trois points de la documentation concernent directement le code d’un agent. Premièrement, la réflexion ne se désactive pas : on règle sa profondeur avec le niveau d’effort (de « low » à « max »), et un code qui envoyait un budget de réflexion à l’ancienne reçoit une erreur. Deuxièmement, le modèle lie ses blocs de réflexion à l’historique de la conversation, et les notes de version préviennent : « Claude Fable 5.2 and Claude Mythos 5.2 enforce the prefix check for every account, whatever its age. » Autrement dit, un agent qui réécrit un message passé, qui change son prompt système en cours de route ou qui modifie sa liste d’outils entre deux tours verra ses requêtes refusées. Un historique en ajout seul est désormais obligatoire. Troisièmement, les garde-fous : « Many queries in these domains are automatically routed to less capable models if flagged by these safeguards. » Un agent doit donc prévoir qu’une réponse vienne d’un modèle de repli, et le journaliser.
Un quatrième point relève du juridique plus que du code : « Using Fable models requires 30-day data retention for safety monitoring by default. » Les organisations qui avaient négocié une rétention nulle auprès d’Anthropic doivent vérifier leur configuration avant de basculer, sans quoi l’API renvoie une erreur. Notre guide pour connecter Claude à ses outils par le MCP reste valable : rien ne change de ce côté.
Dans Claude Code, Fable 5.2 devient le Fable par défaut
Le journal des versions de Claude Code indique, dans la version 2.1.321 du 9 novembre 2026, l’ajout de Claude Fable 5.2 « now the default Fable model », et précise : « Changed saved Fable 5.1 model picks to move to fable: on Pro and Max plans at once, on Team and Enterprise plans once your organization allows it; use /model claude-fable-5-1 to switch back » (changelog de Claude Code). Concrètement, quiconque avait choisi Fable 5.1 sur un abonnement Pro ou Max se retrouve sur Fable 5.2 à la mise à jour suivante, sans rien faire ; sur Team et Enterprise, c’est l’administrateur qui ouvre la porte.
Chez nous, c’est encore à faire : le 14 novembre, le Claude Code de notre serveur est en version 2.1.308 et toujours réglé sur Fable 5.1. La bascule viendra avec la mise à jour. Ce que ça coûte en abonnement ne bouge pas, c’est l’objet de notre article sur le prix de Claude Code : le modèle change, la formule reste.
Notre donnée maison : 93 plans de montage écrits par Claude Opus 5.5
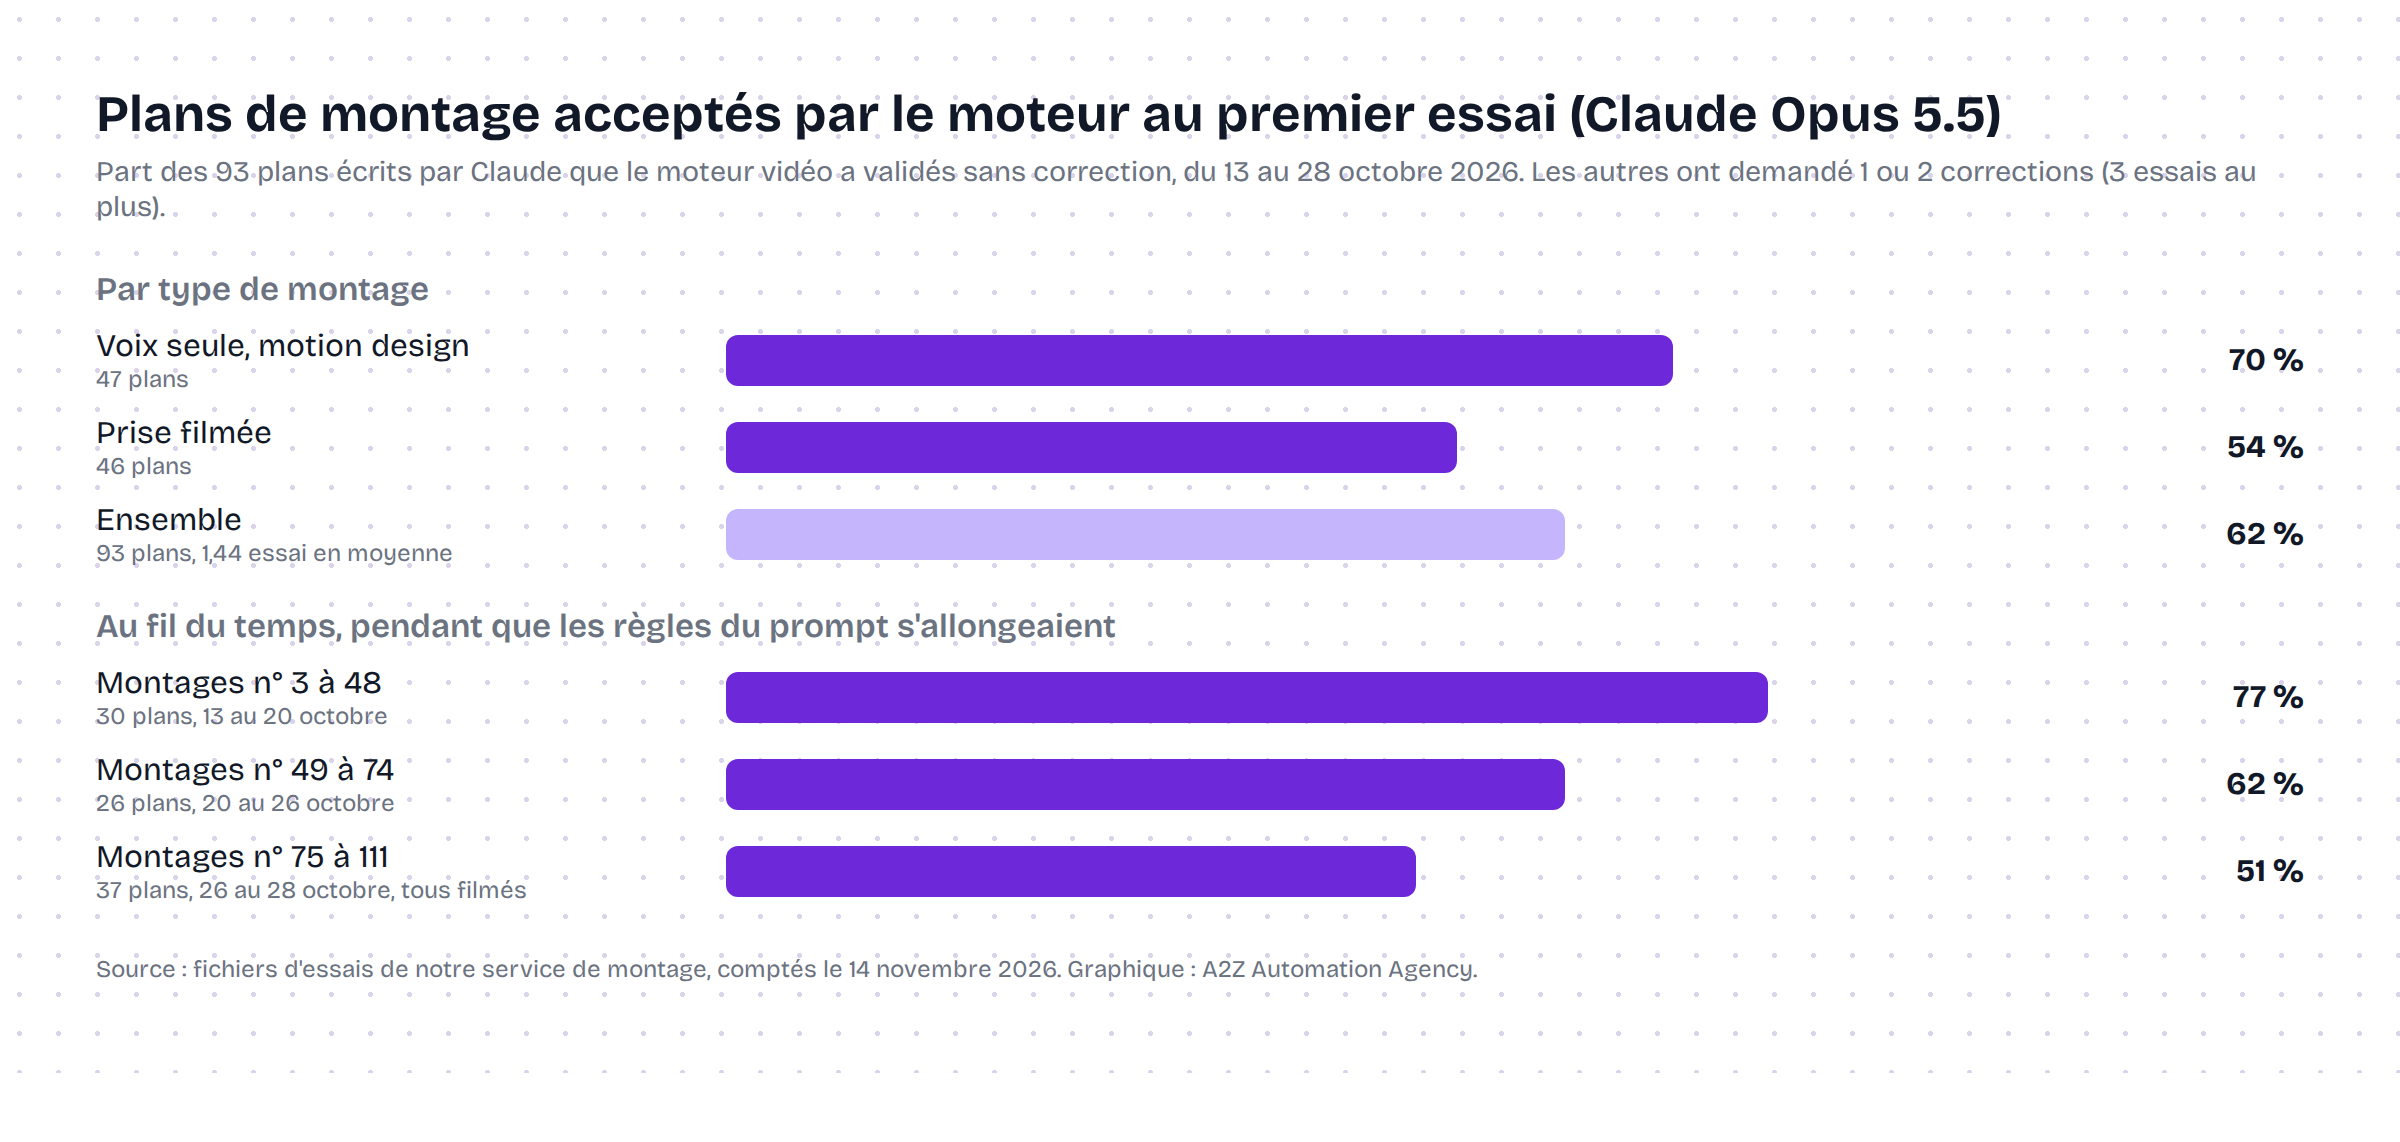
Méthode : comptage, le 14 novembre 2026, des fichiers d’essais conservés par notre service de montage pour chaque montage réalisé entre le 13 et le 28 octobre 2026. Le service envoie à Claude la transcription horodatée d’un mémo (190 mots en médiane, 63 secondes de vidéo en médiane) avec un prompt système de 70 371 caractères (les règles de mise en scène, 13 920 caractères, plus le catalogue des personnages, des écrans et le schéma JSON du plan). Le moteur vidéo valide le plan reçu ; s’il le refuse, les erreurs sont renvoyées à Claude dans la même conversation, trois essais au plus. Le modèle est Claude Opus 5.5, effort « high », prompt système mis en cache.
| Mesure | Valeur |
|---|---|
| Plans écrits par Claude Opus 5.5 | 93 (sur 111 montages ; les autres ont un plan fourni ou sont des démonstrations) |
| Acceptés au premier essai | 58, soit 62 % |
| Deux essais | 29 (31 %) |
| Trois essais | 6 (6 %) |
| Essais par plan, en moyenne | 1,44 |
| Voix seule, motion design (47 plans) | 70 % au premier essai |
| Prise filmée (46 plans) | 54 % au premier essai |
| Montages n° 3 à 48, du 13 au 20 octobre (30 plans) | 77 % |
| Montages n° 49 à 74, du 20 au 26 octobre (26 plans) | 62 % |
| Montages n° 75 à 111, du 26 au 28 octobre (37 plans, tous filmés) | 51 % |
| Coût d’un plan | environ 0,08 $ (mesure du 13 octobre 2026, sur la vidéo de démonstration) |
Le chiffre qui nous intéresse n’est pas les 62 %, c’est la pente. Au fil d’octobre, le taux de plans acceptés du premier coup est passé de 77 % à 51 %, et ce n’est pas le modèle qui a changé : ce sont nos règles. Chaque retour des associés sur une vidéo a ajouté une contrainte au prompt (accroche obligatoire, écrans de l’application calés au mot près, poses à ne pas répéter, inserts limités à 40 % en prise filmée). Plus le règlement s’allonge, plus Opus 5.5 rate une contrainte au premier passage, et plus souvent le moteur lui renvoie une correction. Chaque correction, c’est un deuxième appel payé, et une minute de plus avant la vidéo.
Ce qu’un passage à Fable 5.2 changerait, et ce que nous n’avons pas mesuré
Côté code, la bascule tient en une ligne : le nom du modèle dans la configuration du service. Notre planificateur est déjà conforme aux exigences de Fable 5.2, sans l’avoir cherché : l’historique de la conversation est en ajout seul (la réponse complète de Claude, blocs de réflexion compris, est renvoyée telle quelle), aucun appel d’outil n’est forcé, et le repli serveur en cas de refus par les garde-fous est activé depuis le premier jour. Les règles d’écriture d’agent que nous appliquons chez nos clients sont les mêmes.
Côté coût, nous ne pouvons que borner. Le plan est facturé en trois parts : la lecture du prompt système en cache, au même prix sur les deux modèles ; la transcription en entrée, deux fois plus chère sur Fable 5.2 ; la réponse et la réflexion en sortie, deux fois plus chères aussi. Un plan qui coûte environ 0,08 $ sur Opus 5.5 coûterait donc entre 0,08 $ et 0,16 $ sur Fable 5.2 à nombre de jetons égal, et plus probablement vers le haut de cette fourchette, parce que la sortie pèse plus lourd que le cache. C’est une déduction à partir des tarifs, pas une mesure.
Côté qualité, l’hypothèse est claire : un modèle qui respecte mieux un long règlement au premier essai économise les appels de correction. Si Fable 5.2 faisait passer notre taux de 62 % à 80 %, les plans en deux ou trois essais tomberaient et le surcoût unitaire serait en partie compensé. C’est exactement ce que nous voulions mesurer pour cet article, en rejouant un échantillon de mémos sur les deux modèles. Nous ne l’avons pas fait : ce rejeu est un lot d’appels payants que notre propre règle interne, « aucune dépense sans accord explicite », nous interdisait de lancer dans le temps de rédaction. Nous publierons les chiffres quand ils existeront, dans une mise à jour de cet article, plutôt que d’écrire un pourcentage que personne n’a vu.
Quel modèle pour quel agent
- Un agent qui pilote d’autres agents, ou qui travaille des heures sur un problème mal défini (audit d’un code, enquête sur un incident, recherche longue) : Fable 5.2, c’est le cas d’usage qu’Anthropic met en avant, et le seul où le prix double se justifie d’emblée.
- Un agent qui produit un livrable structuré à partir d’un règlement long, comme notre plan de montage : Opus 5.5 reste notre choix tant que le taux de corrections n’est pas mesuré sur Fable 5.2. Nous mesurerons avant de changer.
- Un agent qui clique dans des interfaces : Opus 5.5, à 2 points de Fable 5.2 sur OSWorld 2.1 selon Anthropic, pour la moitié du prix.
- Une étape de classification, d’extraction ou de tri dans un workflow n8n : Haiku 5.5 ou Sonnet 5.5. Mettre Fable 5.2 là, c’est payer 80 fois le prix de Haiku pour lire un e-mail.
- Dans tous les cas : un prompt système stable et en cache, un historique en ajout seul, un journal des refus et des replis. Ce sont ces trois réflexes qui font qu’un changement de modèle se résume à une ligne de configuration.
Si vous voulez qu’on regarde votre cas, avec vos volumes et vos appels réels, c’est l’objet d’un premier échange sur notre page de rendez-vous.
Les limites
Les benchmarks cités sont ceux d’Anthropic, mesurés par Anthropic, sur des tâches choisies par Anthropic ; ils situent le modèle, ils ne prédisent pas votre cas. Notre taux de 62 % porte sur un seul type d’agent, le nôtre, avec un prompt qui a changé pendant la période : la baisse de 77 % à 51 % mêle l’allongement des règles et l’arrivée des prises filmées, plus contraignantes, et nous ne savons pas séparer les deux. La fourchette de 0,08 $ à 0,16 $ par plan est déduite des tarifs, pas mesurée. Les prix sont ceux du 14 novembre 2026 et changent sans préavis. Enfin, notre serveur n’est pas encore passé en Claude Code 2.1.321 : nous décrivons la bascule automatique d’après le journal des versions, pas d’après notre propre écran.
Questions fréquentes
Claude Fable 5.2 remplace-t-il Opus 5.5 ?
Non. Les deux coexistent au catalogue. Fable 5.2 est positionné sur le raisonnement exigeant et les agents de longue durée, Opus 5.5 sur le travail agentique courant, à la moitié du prix. Anthropic ne recommande pas de tout basculer sur Fable.
Quelle différence entre Fable 5.2 et Mythos 5.2 ?
Mêmes capacités, mêmes prix, mais Mythos 5.2 n’est accessible qu’aux organisations vérifiées par les programmes d’Anthropic, pour des travaux de cybersécurité ou de sciences de la vie. Pour une PME ou une agence, le modèle disponible est Fable 5.2.
Combien coûte Claude Fable 5.2 ?
8 $ par million de jetons en entrée, 40 $ en sortie et 0,20 $ en lecture de cache, relevé du 14 novembre 2026 sur platform.claude.com. C’est 20 % de moins que Fable 5.1. Le mode rapide coûte le double. Dans claude.ai et Claude Code, il est inclus dans les abonnements Pro, Max, Ultra, Team et Enterprise.
Faut-il modifier son code pour passer de Fable 5.1 à Fable 5.2 ?
Le nom du modèle change, et la vérification de l’historique s’applique désormais à tous les comptes : un agent qui réécrit son prompt système ou ses outils en cours de conversation doit être corrigé avant la bascule. Un agent déjà écrit en ajout seul, comme le nôtre, passe sans autre changement.
Vos vidéos sont-elles déjà montées par Fable 5.2 ?
Non. Le plan de montage est écrit par Claude Opus 5.5, qui donne 62 % de plans acceptés au premier essai sur 93 plans. Nous rejouerons un échantillon sur Fable 5.2 avant de décider, et nous publierons la mesure.
Vous voulez mettre ça en place chez vous ?
Adam, qui conçoit nos workflows n8n et nos agents IA, regarde votre cas avec vous : 30 minutes en visio pour comprendre vos processus, repérer ce qui vaut la peine d'être automatisé et vous dire comment nous le ferions.
Choisir un créneau


